728x90
반응형

0. 준비

- docker(또는 Finch) 설치되어 있고 실행 중이어야 함

(ASH는 내부적으로 컨테이너를 띄워서 스캔함)

- 인터넷 가능한 환경에어야 함 (스캐너 이미지 받아오기 위함)

docker ps
brew install colima docker
colima start


1. 설치

- pipx 없으면 pip install --user pipx 먼저, 또는 그냥 pip install automated-security-helper

brew install python@3.12
# pipx install --python python3.12 "git+https://github.com/awslabs/automated-security-helper.git@v3.7.0"
pipx install --python /opt/homebrew/bin/python3.12 "git+https://github.com/awslabs/automated-security-helper.git@v3.7.0"

# 아래 명령은 AWS ASH 설치 도구가 아닌 것으로 확인됨
# pip3 install --user pipx
# pipx install automated-security-helper


installed package automated-security-helper 3.7.0, installed using Python 3.12.14
These apps are now globally available
  - ash
  - ashv3
  - automated-security-helper
done! ✨ 🌟 ✨


설치되면 ash 명령어가 생김. 확인:

ash --version
awslabs/automated-security-helper v3.7.0


2. 스캔할 코드 폴더로 이동

cd ~/내프로젝트경로


3. 실행

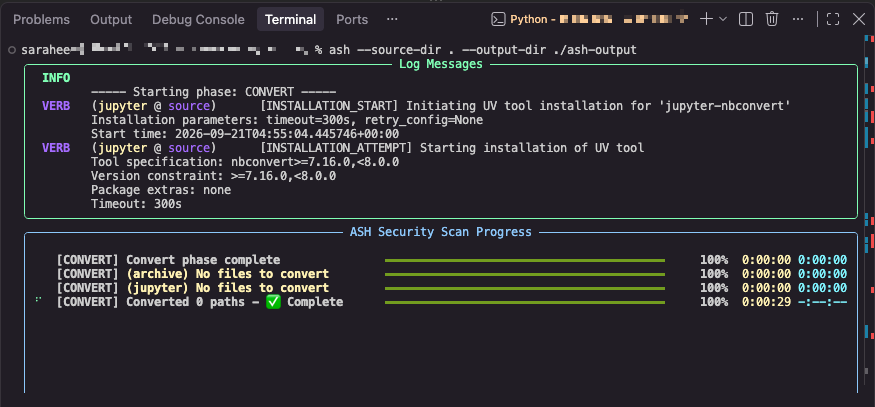
ash --source-dir . --output-dir ./ash-output

# --source-dir . = 지금 폴더(현재 프로젝트) 스캔
# --output-dir ./ash-output = 결과 저장할 폴더


- 첫 실행은 스캐너 컨테이너 이미지를 받아오느라 몇 분 걸림. 이후엔 캐시돼서 빨라짐
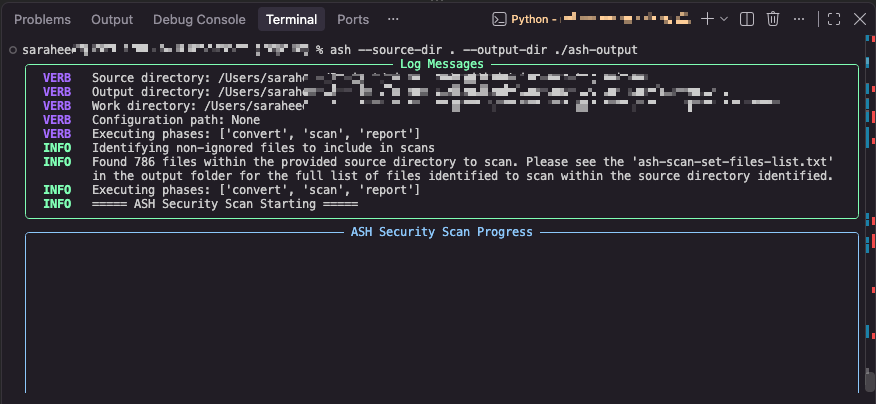


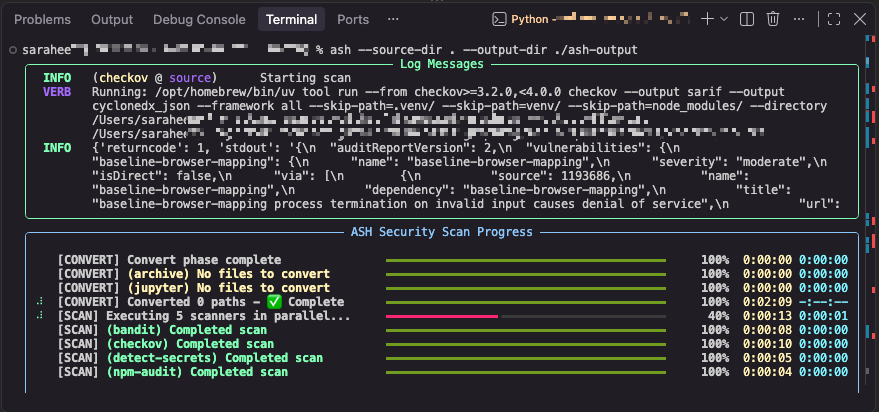
checkov crash(ERROR)나는 경우, 병렬 처리를 끄고 스캔

CHECKOV_PARALLELIZATION_TYPE=none \
ash \
  --mode local \
  --output-dir ../ash-output/ash-output-cd


CHECKOV_PARALLELIZATION_TYPE=none \
ash \
  --mode local \
  --output-dir ../ash-output/ash-output-cd \
  --config-overrides 'scanners.checkov.options.additional_formats=[]'


4. 결과 확인
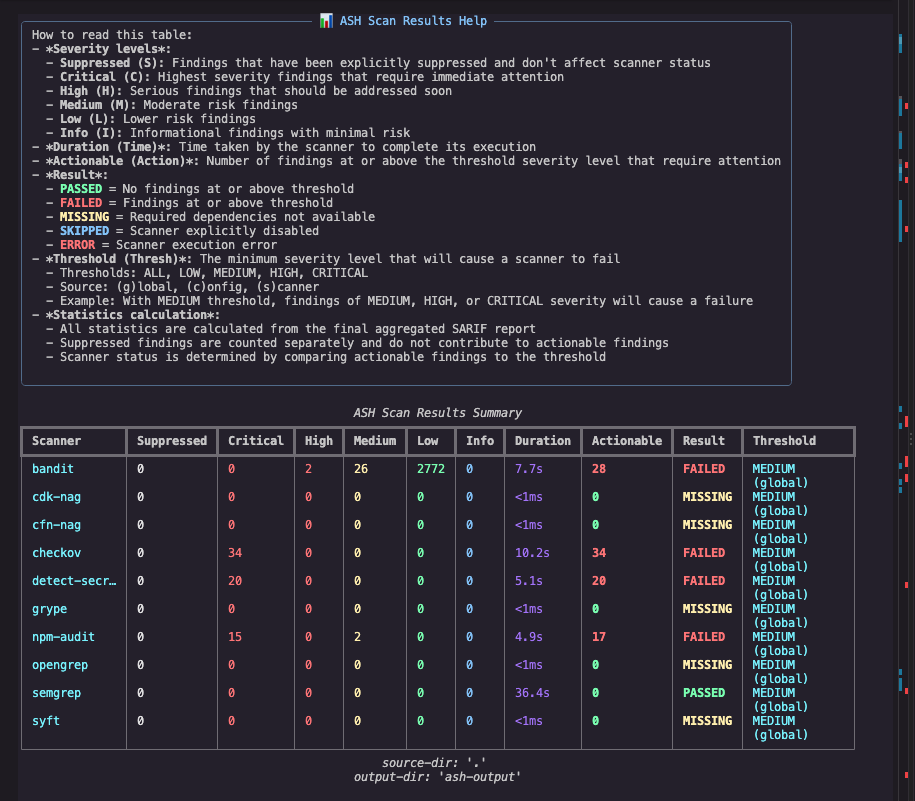
 

./ash-output/ 폴더 내에:
- 종합 리포트(HTML/JSON) — 심각도별로 취약점 정리된 것
- 스캐너별 세부 결과(Bandit, Semgrep, Checkov 등 각각의 원본 결과)

HTML 리포트를 브라우저로 열어보는 게 제일 보기 편함


5. 대응

심각도(Critical/High부터) 순서로 하나씩 보면서, 실제 취약점인지 오탐인지 판단 → 실제면 코드 고치고, 오탐이면 무시 처리(suppress) 규칙 추가.

.ash.yaml

global_settings:
  suppressions:
    - rule_id: 'RULE-123'
      path: 'src/example.py'
      line_start: 10
      line_end: 15
      reason: 'False positive due to test mock'
      expiration: '2025-12-31'
    - rule_id: 'RULE-456'
      path: 'src/*.js'
      reason: 'Known issue, planned for fix in v2.0'

- 링크: Configuring Suppressions - https://github.com/awslabs/automated-security-helper/blob/main/docs/content/docs/suppressions.md#configuring-suppressions


* 참고

ash --help

- 실제 지원하는 옵션 확인


728x90
728x90
728x90
반응형


1. main 브랜치 이동 및 원격의 최신 커밋 가져오기

git switch main
git pull


2. 브랜치 따기

- -c: create

git switch -c feat/bedrock-reasoning-models


fix/... 버그 수정

feat/... 기능 추가

chore/... 설정·정리


3. 파일 수정


4. 변경사항 확인

git status
git diff


5. 커밋

git add .
git commit -m "feat(bedrock): separate guardrail for assistant"


6. 원격에 올리기

git push -u origin feat/bedrock-reasoning-models


7. PR 생성

웹으로 보기

gh pr view --web


CLI로:

gh pr create --base main --title "fix(llm): Bedrock Converse - reasoning 모델 지원" --body "$(cat <<'EOF'
## 문제
`bedrock.py`의 `generate()`가 응답을 `content[0]["text"]`로 읽는다. reasoning 모델(GPT-5.6, grok)은 `content[0]`에 `reasoningContent` 블록을 넣고 `text`를 뒤에 두므로 `KeyError: 'text'` → HTTP 500.

또한 `temperature`를 항상 전송하는데, GPT 계열과 Claude 신모델은 이 필드를 거부한다(`ValidationException`).

## 변경
- 응답 블록 전체를 훑어 `text` 키를 가진 블록만 선택
- 텍스트가 비었거나 `stopReason == "max_tokens"`인 경우 경고 로그
- `temperature`를 받지 않는 모델군에서는 전송 생략
- 모델군별 추론 비활성화 필드 지정

## 재현
aws bedrock-runtime converse --region ap-northeast-2
  --model-id global.openai.gpt-5.6-sol
  --messages '[{"role":"user","content":[{"text":"복잡한 SQL 생성 요청"}]}]'
  --inference-config '{"maxTokens":4096}'
응답 `content[0]`이 `reasoningContent`인 것을 확인할 수 있다.

## 검증
`/api/v1/search` 1건 기준: 수정 전 HTTP 500 → 수정 후 200 (ev 40, sql 2)
EOF
)"


간단히 하려면 gh pr create --fill (커밋 메시지로 자동 채움) 후 웹에서 본문 편집해도 됨

웹으로: push 하면 터미널에 PR 생성 링크가 출력된다. 그걸 클릭하거나, GitHub 레포 페이지에 뜨는 Compare & pull request 버튼을 누르면 된다.

## Type of Change

- [ ] Feature
- [ ] Bug Fix
- [ ] Refactoring
- [ ] Documentation
- [ ] Other (specify)

## Why? (목적)

<!-- 변경 사항의 목적/배경 -->

## What? (주요 변경 사항)

### Major

-

### Minor

-

## How to Test

<!-- 테스트 환경 셋업 및 검증 방법 -->

```bash
# 실행 명령어
```

### 예상 결과

<!-- 정상 동작 시 기대되는 결과 -->

## Checklist

- [ ] ruff check/format 통과
- [ ] 불필요한 로그/주석 제거
- [ ] Breaking change 여부 확인
- [ ] 문서 업데이트 (해당 시)

## Review Points

<!-- 리뷰어가 특히 봐야 할 부분 -->

## Related Issues

<!-- 관련 이슈 링크 -->


8. 리뷰 반영


9. 머지 후 정리

git switch main
git pull
# 로컬 브랜치 삭제
git branch -d feat/bedrock-reasoning-models


728x90
728x90

'Application > Git' 카테고리의 다른 글

Git Workshop - hugo  (0) 2025.11.05
728x90
반응형

Claude Code를 Amazon Bedrock에 연결하기

1. 사전 준비 확인

# AWS CLI 설치 확인
aws --version

# Claude Code 설치 확인
claude --version

2. AWS 프로파일 확인

# 등록된 프로파일 목록 보기
aws configure list-profiles

# config 파일 직접 확인
cat ~/.aws/config

3. SSO 로그인 (SSO 프로파일 사용 시)

# admin 프로파일로 로그인
aws sso login --profile admin

# 자격증명 정상 확인 (계정 정보 출력되면 성공)
aws sts get-caller-identity --profile admin
기존 프로파일(defaullt) 사용 시: > bash > mwinit -o > aws sts get-caller-identity --profile default

4. 프로파일 이름 정리 (선택)

# config 파일 열기
vi ~/.aws/config

# [profile 긴이름] → [profile admin] 처럼 짧게 수정
# 불필요한 프로파일(your-profile-name 등) 삭제

5. 환경변수 설정 (Bedrock 연동 핵심)

# 사용할 프로파일 지정
export AWS_PROFILE=admin

# Claude Code가 Bedrock을 쓰도록 설정
export CLAUDE_CODE_USE_BEDROCK=1

# 모델이 있는 리전 지정
export AWS_REGION=us-east-1

6. 연결 확인

# 자격증명 최종 확인
aws sts get-caller-identity

7. Claude Code 실행

# 프로젝트 폴더로 이동
mkdir bedrock-agentcore-workshop
cd bedrock-agentcore-workshop

# 실행
claude

⚙️ 매번 설정 귀찮으면 (영구 등록)

# zsh 기준 ~/.zshrc에 추가
cat << 'EOF' >> ~/.zshrc

# Claude Code + Bedrock 설정
export AWS_PROFILE=admin
export CLAUDE_CODE_USE_BEDROCK=1
export AWS_REGION=us-east-1
EOF

# 적용
source ~/.zshrc

🔄 다음날 다시 쓸 때 (SSO는 세션 만료됨)

aws sso login --profile admin
claude

🚨 자주 나는 에러 & 해결

에러 원인 해결
SSO session ... expired SSO 세션 만료 aws sso login --profile admin
InvalidClientTokenId 자격증명 무효 프로파일 재로그인
No accounts available 계정 권한 없음 관리자에게 계정 할당 요청
credential_process ... 실패 인증 만료 mwinit -o


✅ 전체 요약 (복붙용)

# 1. 로그인
aws sso login --profile admin

# 2. 확인
aws sts get-caller-identity --profile admin

# 3. 환경변수
export AWS_PROFILE=admin
export CLAUDE_CODE_USE_BEDROCK=1
export AWS_REGION=us-east-1

# 4. 실행
cd bedrock-agentcore-workshop
claude


728x90
728x90

'Networking > AWS' 카테고리의 다른 글

AWS 정적 분석 ASH  (0) 2026.09.21
백업 체계  (0) 2026.05.12
SSM 통신을 위한 VPC endpoint  (0) 2026.04.10
Control Tower account  (0) 2026.04.07
[Control Tower] sts:AssumeRoot (BreakGlassAssumeRoot)  (0) 2026.03.16
728x90
반응형

서버실에 장비를 직접 두고 쓰는(On-Prem) 환경 기준

현행 가이드 클라우드
테이프 만들어서 금고에 보관 다른 계정/다른 리전으로 복제
WORM 테이프 사용 (못 지우도록) S3 Object Lock
네트워크 선 뽑아서 분리 별도 AWS 계정 + IAM 격리
설정 파일 USB에 백업 Terraform 코드를 Git에 관리
테이프 복원 시간 측정 스냅샷 / AMI 복원 시간 측정


1. 용어 정리

테이프 소산

소산 = 흩어서 보관한다 = 다른 장소로 옮겨 보관

테이프: 백업용 자기 테이프

테이프 소산: 백업 테이프를 만들어서 물리적으로 다른 건물/금고에 가져다 보관하는 것


클라우드 대응: 테이프를 금고에 넣을 필요 없이, 다른 AWS 리전(서울→도쿄)이나 다른 AWS 계정으로 복제

WORM 테이프/디스크

Write Once, Read Many, 한 번 쓰면 수정/삭제 불가, 읽기만 가능 (like DVD-R)

한번 기록하면 덮어쓰기가 물리적으로 불가능한 테이프

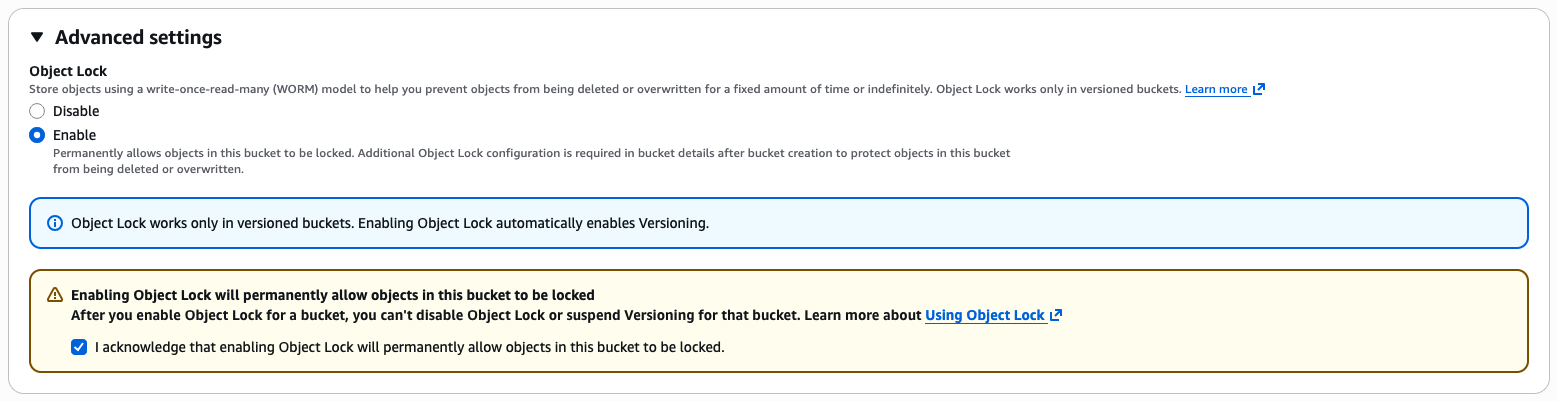
S3 Object Lock

Object: S3에 저장되는 파일 하나하나

S3 Object Lock: S3에 올린 파일을 일정 기간 동안 삭제/수정 못하게 잠그는 기능

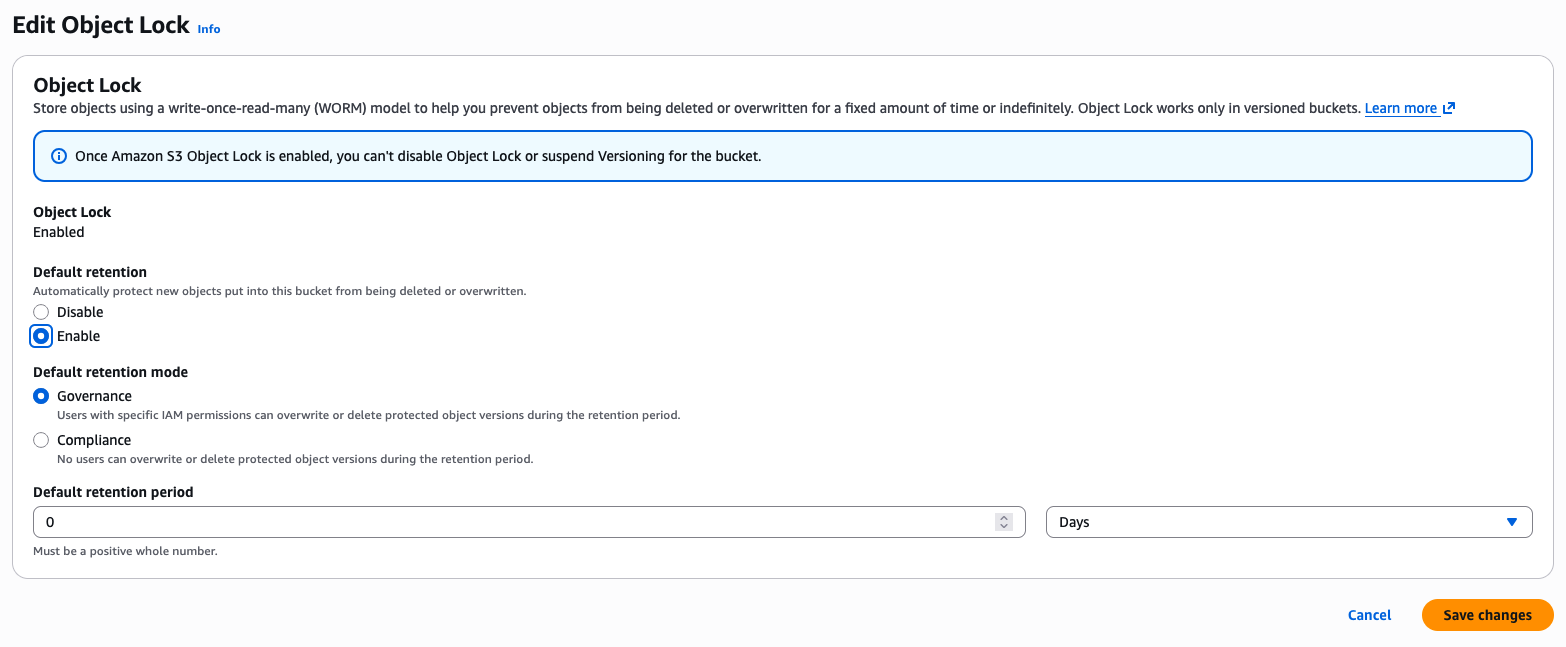
- Governance Mode: 특별 권한 있는 사람은 해제 가능

- Compliance Mode: 아무도 해제 불가(루트 계정도 못 지움)

* 파일 단위 잠금

Governance
Users with specific IAM permissions can overwrite or delete protected object versions during the retention period.

Compliance
No users can overwrite or delete protected object versions during the retention period.

Backup Vault Lock

Backup Vault: AWS Backup 서비스가 백업본을 저장하는 금고

* AWS Backup 전체 금고 단위 잠금

2. 백업 방식 관련 용어

3-2-1 규칙

3개의 백업 복사본을

2가지 다른 종류의 매체에

1개는 반드시 외부(오프사이트)에

예: On-Prem - 서버 자체 디스크, 외장 디스크 백업, 테이프 소산

클라우드 - 원본 EBS 디스크, 같은 리전 스냅샷, 다른 리전/다른 계정 복제본

온라인/오프라인 백업

- 온라인 백업: 시스템 가동 중에 백업 (서비스 중단 없음)

- 오프라인 백업: 시스템 멈추고 백업 (네트워크에서 완전히 분리된 상태)

* 클라우드에서는 오프라인이라는 개념 자체가 없음 → Object Lock으로 "논리적 오프라인"을 대체

스냅샷 / AMI

- 스냅샷: 디스크 사진 찍기, 특정 시점의 디스크 상태를 그대로 저장

- AMI: 서버 통째로 복사, OS + 프로그램 + 설정을 하나의 이미지로 묶은 것. 이걸로 새 서버를 바로 만들 수 있음

PITR (Point-in-Time Recovery)

특정 시점으로 복원

- RDS(데이터베이스)에서 최대 35일 이내 아무 시점 지정하여 특정 시점으로 되돌리기 가능

- 전통적 백업은 "매일 밤 12시 백업본"만 있어서 12시~다음날 사이 데이터는 유실될 수 있으나, PITR은 이를 해결

IaC (Infrastructure as Code)

인프라를 코드로 관리함

- On-Prem: 서버 설정을 엑셀에 기록 → 설정 파일 백업

- 클라우드: Terraform 코드로 인프라를 정의 → Git에 저장 → 코드만 있으면 인프라를 똑같이 재생성 가능

* 설정 파일 백업이 아니라 코드 형상관리(Git)가 백업의 본질


728x90
728x90
728x90
반응형

VPC 엔드포인트 사용의 대체 방법은 관리형 인스턴스에서 아웃바운드 인터넷 액세스를 허용하는 것이다. 이 경우 관리형 인스턴스는 다음 엔드포인트에 대한 HTTPS(포트 443) 아웃바운드 트래픽도 허용해야 한다.

  • ssm.region.amazonaws.com

SSM API 통신 (컨트롤 플레인)

SSM Agent가 SSM 서비스에 자기 자신을 등록(Register) 하고, 파라미터 조회, 명령 결과 보고 등 API 호출

  • ssmmessages.region.amazonaws.com

Session Manager 데이터 채널 (WebSocket)

Session Manager로 셸 접속할 때의 실시간 양방향 통신 (키보드 입력 → EC2, EC2 출력 → 콘솔 화면)

  • ec2messages.region.amazonaws.com

Run Command / State Manager 메시지 채널 (Polling)

SSM Agent가 SSM 서비스를 주기적으로 폴링하여 "실행할 명령이 있나?" 확인하고 결과를 반환


728x90
728x90
728x90
반응형

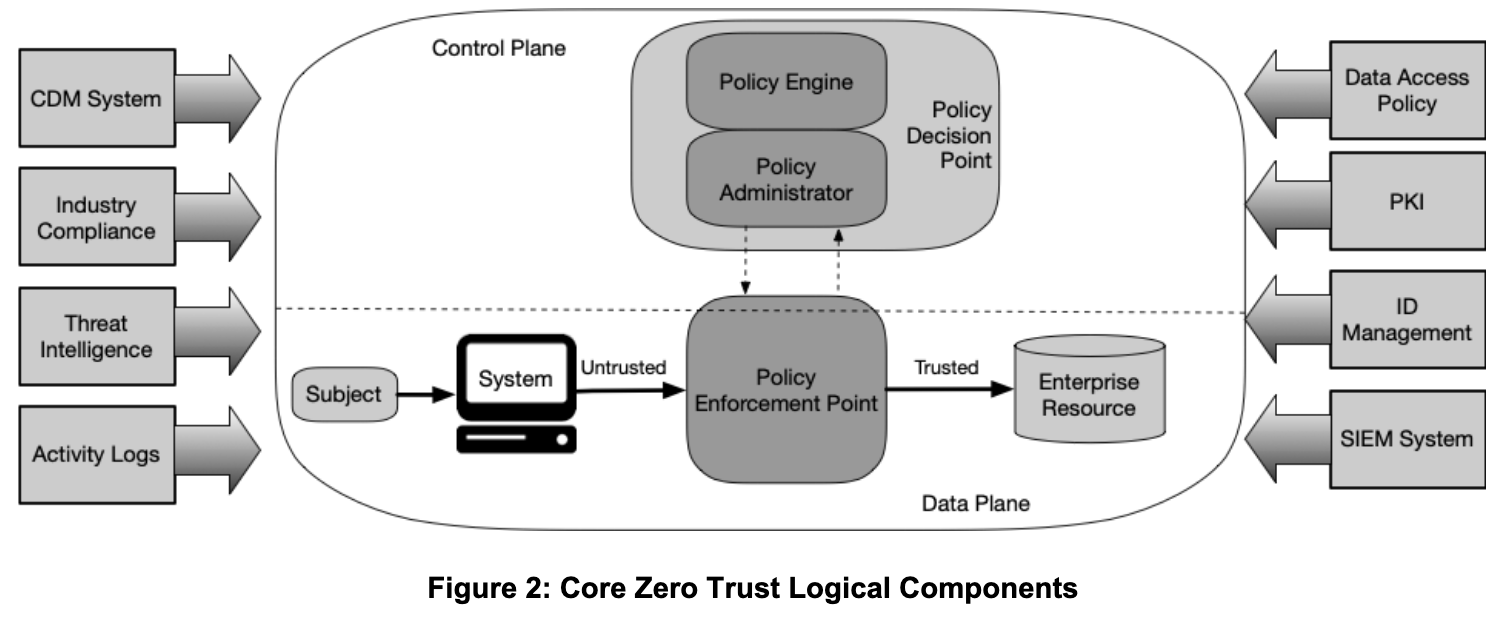
Logical Components of Zero Trust Architecture

서브젝트(Subject)

컴퓨터 시스템에서 작동, 엔터프라이즈 리소스에 접속할 수 있는 개념

애플리케이션 또는 장치로 정의


리소스(resource)

제로 트러스트 시스템에서 보호해야 하는 기업의 애플리케이션, 데이터, 문서나 워크로드


정책 적용 지점(PEP, Policy Enforcement Point)

리소스에 접속할 수 있는 지점


정책 결정 지점(PDP, Policy Decision Point)

ID를 확인(인증)받고 ID와 콘텍스트에 따라 해당 서브젝트에 최소한의 권한만 부여하고 이것을 PEP가 실행하는 형태


References: 

[1] Zero Trust Architecture, NIST Special Publication 800-207, https://nvlpubs.nist.gov/nistpubs/SpecialPublications/NIST.SP.800-207.pdf


728x90
728x90
728x90
반응형

RAG와 에이전트

색인화(index): 나중에 빠르게 검색할 수 있도록 데이터를 처리하는 작업

질의(query): 관련 데이터를 검색하기 위해 시스템에 요청을 전송하는 과정

청크(chunk): 문서를 더 관리하기 쉬운 분할 방법, 문서 전체를 그냥 검색하면 컨텍스트가 지나치게 길어질 수 있기 때문


의미 기반 검색(semantic retrieval): 임베딩 기반 검색기의 문서의 의미가 질의와 얼마나 가까운지를 기준으로 순위를 매기는 방식

벡터 데이터베이스(vector database): 임베딩을 저장하는 데이터베이스 (임베딩 기반 검색에서 색인화가 하는, 원본 데이터 청크를 임베딩으로 변환하여 만들어진 임베딩)


컨텍스트 정밀도(context precision): 검색된 모든 문서 중에서 실제로 질의와 관련된 문서의 비율은 얼마인가?

컨텍스트 재현율(context recall): 질의와 관련된 모든 문서 중에서 실제로 검색된 문서의 비율은 얼마인가?

7. 파인튜닝

모델 전체나 일부를 추가로 학습시켜 특정 작업에 맞게 모델을 조정하는 과정

모델의 가중치를 요청하는 방식으로 모델을 조정하는 방식으로 모델을 변화시킴

(↔ 모델에 지시, 컨텍스트, 도구를 제공해 모델을 조정하는 프롬프트 기반 방법)

7.1. 파인튜닝 개요

파인튜닝은 전이 학습(transfer learning, TL)의 한 방법인데, 전이 학습은 1976년 보지노프스키(Bozinovski)와 풀고시(Fulgosi)가 처음 제안한 개념

전이 학습: 한 작업에서 얻은 지식을 새롭지만 관련된 작업에 활용해 학습 속도를 높이는 데 중점을 둠


전이 학습은 표본 효율성(sample efficiency)을 높여 모델이 더 적은 예시로도 같은 행동을 학습할 수 있게 함


지속적 사전 학습(continued pre-training): 자기 지도 파인튜닝 

- 비싼 작업별 데이터로 사전 학습 모델을 파인튜닝하기 전에, 저렴한 관련 분야 데이터로 먼저 자기 지도 학습을 적용


인필링 파인튜닝(infilling finetunning): 지도 파인튜닝을 통해 (다음 토큰을 예측하거나) 빈칸을 채우도록 모델을 파인튜닝

- 앞뒤 토큰을 모두 활용해 빈칸을 채우는 마스크 모델, 텍스트 편집 및 코드 디버깅 같은 작업에 특히 유용함


롱 컨텍스트 파인튜닝(long-context finetunning): 컨텍스트 길이를 늘리기 위해 모델을 파인튜닝

- 위치 임베딩 조정 같은 모델 구조의 수정이 필요

7.2. 파인튜닝이 필요한 경우

JSON이나 YAML 같은 특정 구조의 출력을 생성할 때, 파인튜닝이 효과적임

7.3. 메모리 병목 현상

부분 파인튜닝(partial finetuning): 모델 파라미터의 일부만 업데이트

파라미터 효율적(parameter-efficient, PEFT): 적은 파라미터를 사용하면서도 전체 파인튜닝에 가까운 성능을 달성하는 기법

- 일반적으로, 수십 배 더 적은 학습 가능한 파라미터를 사용해 전체 파인튜닝에 근접한 성능을 달성할 수 있다면 파라미터 효율적이라고 봄


랭크: 원본 가중치 행렬을 두 개의 작은 행렬로 분해할 때의 차원 크기

가중치: 뉴런 간 연결의 강도

양자화(quantization): 정밀도를 낮추는 것

- 모델 값을 표현하는 데 필요한 비트 수가 적을수록, 모델의 메모리 사용량도 줄어듦

- 100억 파라미터 모델이 32비트 형식이면 가중치에 40GB가 필요하지만, 같은 모델이 16비트 형식으로 표현하면 20GB면 충분함


선형 결합, 구면 선형 보간법

PEFT 기법들

어댑터 기반 방법(adapter-based method): 모델 가중치에 추가 모듈을 붙이는 모든 방식, 파라미터를 추가하기 때문에 부가적 방법이라고도 부름 (모델 구조에 학습 가능한 파라미터를 추가)

- 예: LoRA, BitFit, IA3, LongLoRA

소프트 프롬프트 기반 방법(soft prompt-based method): 특별한 학습 가능한 토큰을 도입해 모델이 입력을 처리하는 방식을 바꿈

- 예: 프리픽스 튜닝, P-튜닝, 프롬프트 튜닝

LoRA

로라가 쓰이는? 이유가, 풀 파인튜닝하면 파라미터가 박혀서 기존에 작업하던 것도 멍청해짐 → 그걸 재앙적 망각이라고 함


개별 가중치 행렬에 적용 가능, 특정 가중치 행렬이 주어지면 LoRA는 이 행렬을 두 개의 더 작은 행렬의 곱으로 분해하고, 이 작은 행렬들을 업데이트한 후 다시 원래 행렬로 병합하는 방식


n x m 차원의 가중치 행렬 W

1. 더 작은 행렬들의 차원을 선택, 선택된 값을 r이라고 하자.

두 개의 행렬을 구성: A(n x r 차원)와 B(r x m 차원)

두 행렬의 곱 W_{AB}는 원래 행렬 W와 동일한 차원을 가진다. (여기서 r은 LoRA 랭크라고 부름)

2. W_{AB}를 원래 가중치 행렬 W에 더해 새로운 가중치 행렬 W'를 생성. 모델에서는 W 대신 W'을 사용.

하이퍼파라미터 α를 통해 W_{AB}가 새 행렬에 얼마나 영향을 미칠지 조절할 수 있다: W' = W + α/r W_{AB}

3. 파인튜닝 과정에서는 A와 B의 파라미터만 업데이트하고, W는 변경하지 않고 그대로 유지한다.


LoRA는 오래전부터 활용되어 온 차원 축소 기법인 저랭크 분해(low-rank factorization) 개념을 토대로 만들어짐

이 방식의 핵심은 큰 행렬을 두 개의 작은 행렬 곱으로 분해해 파라미터 수를 줄여서 계산량과 메모리 요구사항을 줄여줌

예: 9 x 9 행렬은 9 x 1과 1 x 9 크기의 두 행렬 곱으로 분해

- 원래 행렬은 81개의 파라미터를 가지지만, 분해된 두 행렬은 합해서 단 18개의 파라미터만 필요함


-

Fine-Tuning 방법의 계층 구조: 복잡도에 따라 4단계로 구분한다.

  1. 풀 튜닝(Full Tuning) - 가장 단순하지만 비용이 많이 듦
  2. 프롬프팅(Prompting) - 중간 단계
  3. 검색 증강 생성(RAG) - 더 복잡한 방식
  4. 파라미터 효율적 튜닝(PEFT) - 가장 복잡하지만 효율적


728x90
728x90

'Application > AI' 카테고리의 다른 글

AI 언어 모델  (0) 2026.04.07
Attention is all you need  (0) 2026.02.18
QLoRA 데이터 형식/변환  (0) 2026.02.18
728x90
반응형
  • user+management@example.com - for your management account
  • user+logs@example.com - for your log archive account
  • user+audit@example.com - for your audit account
  • user+sandbox@example.com - for your sandbox account, created via the Account factory

AWS CLI v2 with IAM Identity Center

From your terminal, run the following command to sign-in to IAM Identity Center.

aws configure sso


Profile name [AWSAdministratorAccess-0112xxxxxxxx]: ManagementAccount

aws sts get-caller-identity --query 'Account' --output text --profile ManagementAccount


Control catalog

SCP (Service Control Policy), RCP (Resource Control Policy)

SCP: 모든 IAM 주체(사용자, 역할)에게 영향

RCP: 리소스 레벨 (지원 리소스: S3 버킷, Lambda 함수)


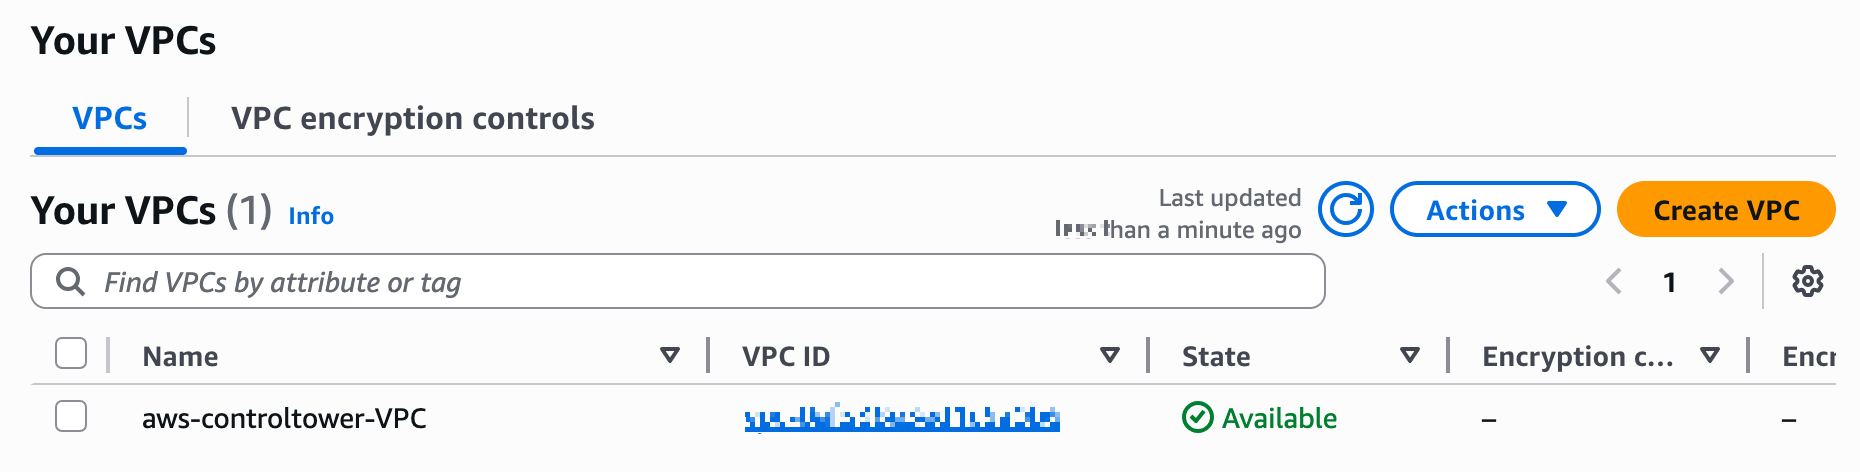
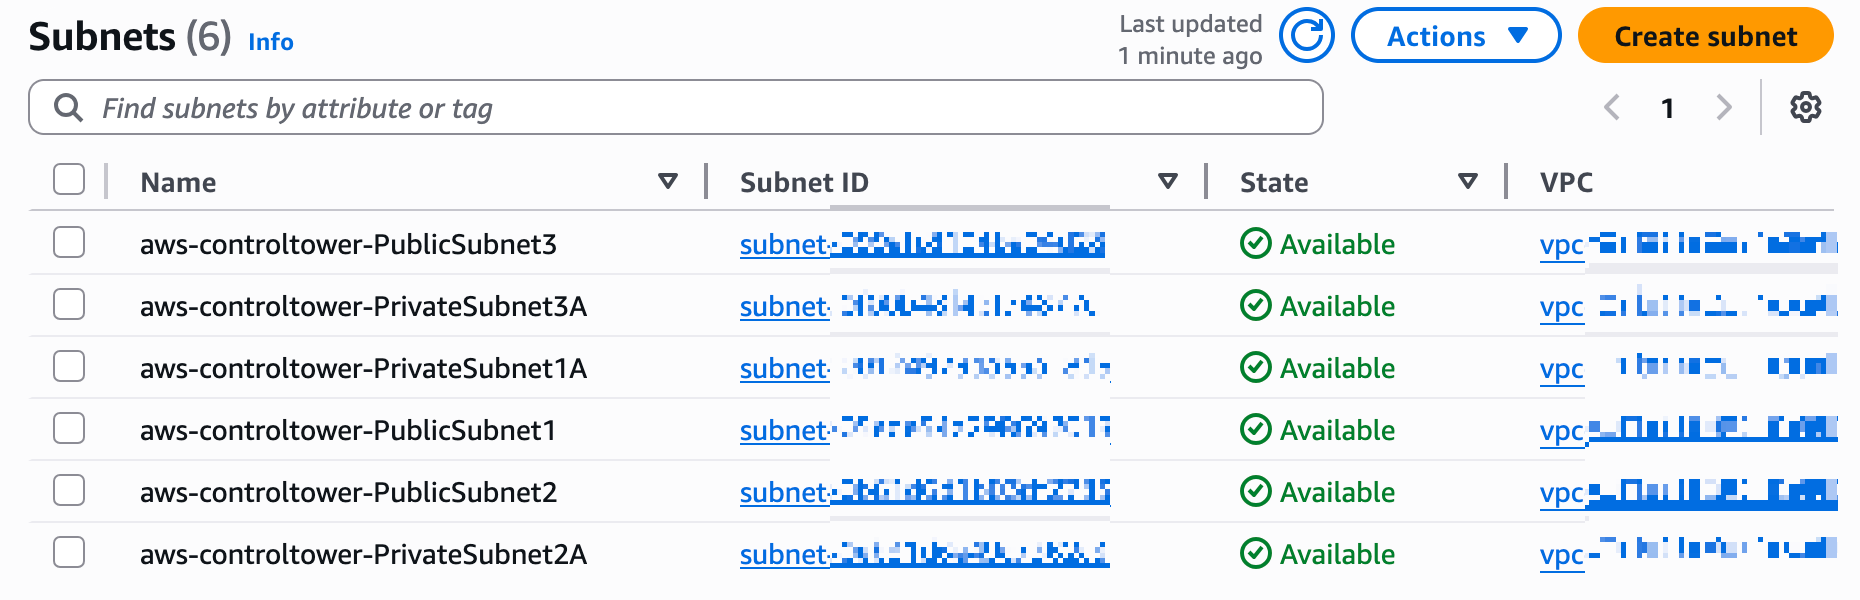
Account Factory에서 Default VPC 설정 수행 시 

Control Tower 관리 CloudFormation Stack 확인

- Account Baseline, Security Baseline이 기본으로 설정됨, CT 관리 계정에서 CloudFormation StackSet으로 관리됨


References:

AWS Control Tower Guide, https://catalog.workshops.aws/control-tower/en-US/prerequisites/email-addresses


AWS Control Tower Workshop

AWS Control Tower Workshop Studio

catalog.workshops.aws


728x90
728x90

'Networking > AWS' 카테고리의 다른 글

백업 체계  (0) 2026.05.12
SSM 통신을 위한 VPC endpoint  (0) 2026.04.10
[Control Tower] sts:AssumeRoot (BreakGlassAssumeRoot)  (0) 2026.03.16
Enable AWS Control Tower  (0) 2026.02.10
[AWS] CloudFormation Workshop#01 - template and stack  (0) 2025.11.20

+ Recent posts